はじめに――超優秀な部下を持った上司の悲劇
日曜日、雨でゴルフのラウンドが中止になった。練習を終え、ゴルフ場のレストランで昼食を取りながら、損害保険会社から依頼されたバッテリーの火災に関する技術見解書を精査していた。この見解書の作成には、ChatGPTとClaudeという二つの生成AIを使っている。ChatGPTと全体構想や論点を整理し、Claudeに詳細な調査を依頼する。Claudeの成果物をChatGPTに批判的に評価させ、修正点を検討する。最終的な判断は、技術士である私自身が行う。この作業を繰り返すうちに、あることに気づいた。
AIが優秀になればなるほど、人間のリーダーシップは重要になるのではないか。私は長年、企業組織の中で上司と部下の関係を考えてきた。その経験から、一人の上司と一人の極めて優秀な部下という関係には、ある種の危うさがあると感じている。部下が何を頼んでも完璧にこなすようになると、上司は次第に自ら考えなくなる。「彼に任せておけば大丈夫だ」。こうして、上司の判断や指揮が形骸化していく。ところが、異なる能力を持つ部下が複数いると、状況は変わる。部下によって意見が違い、得意分野も異なる。時には互いの提案を批判する。上司は、それぞれの意見を聞き、比較し、判断しなければならない。
上司の仕事は、部下より優秀になることではない。異なる能力を統合し、組織として成果を生み出すことである。この考え方をAIにも応用できないだろうか。本稿では、二つのリーダーシップと三つのAI組織方式を組み合わせ、AI時代のリーダーシップを考える。先に結論を述べておく。複数のAIを使うだけでは、リーダーシップは守れない。守れるのは、AI同士の食い違いや批判を材料にして、人間が自分で確かめ、判断する仕組みを作ったときである。
AIが人間より優秀になったとき、上司のリーダーシップはどうなるのか。一つの優秀なAIに頼り切れば、人間は自ら考え、判断する力を失いかねない。一方、複数のAIに異なる役割を与え、互いの成果を批判的に検証させれば、判断の質を高める可能性がある。本稿では、二つのリーダーシップと三つのAI組織方式を組み合わせた六つの活用戦略を提案する。技術調査や報告書作成、経営戦略の立案を例に、AIへの仕事の任せ方、相互検証の方法、人間が判断すべきポイントを具体的に示す。AI時代のリーダーに必要なのは、AIより優秀になることではなく、AIを組織し、その能力を成果につなげることである。
第1章 リーダーシップの本質とは何か
1.1 リーダーが担う四つの機能
リーダーシップを考えるうえで、私は次の四つの機能が重要だと考えている。
- 目標設定:何を達成するかを決める
- 仕事の配分:誰に何を任せるかを決める
- 評価と選択:成果を比較し、採用する案を決める
- 修正と停止:必要に応じて方向を変え、止める
AIがどれほど優秀になっても、この四つを人間が主体的に行使していれば、リーダーシップは維持できる可能性がある。逆に、AIにすべてを委ねれば、人間は形式上の責任者にすぎなくなる。これは技術の問題ではなく、組織設計の問題である。
1.2 二つのリーダーシップ
本稿では、リーダーシップを「実務型」と「ビジョン型」という二つの役割に分けて考える。
表1 実務型とビジョン型
| 比較項目 | 実務型 | ビジョン型 |
|---|---|---|
| 基本的な役割 | ミッションの達成 | 将来の方向性の提示 |
| 中心的な問い | どう実現するか | 何を目指すか |
| 課題の性質 | 正解を事実と照合できる | 正解は後になって分かる |
| 主な責任 | 成果・品質・実行 | 戦略・変革・方向性 |
| AIへの期待 | 調査・分析・実行支援 | 未来予測・戦略支援 |
| 人間の判断 | 成果物の採否 | 目指す未来の選択 |
この分類は、経営学の「変革型」と「取引型」リーダーシップに部分的に対応するが、同一ではない。87文献を統合したメタ分析では、両者の相関は0.80と高く、どちらも成果を予測した(Judge & Piccolo, 2004)。優れたリーダーは両方を使い分けている。したがって本稿の分類も、人間を二種類に分けるものではない。同じ人間が、状況に応じて両方の役割を担う。この区別には実証的な手がかりもある。106の実験を分析したMITのメタ分析では、人間とAIの組合せは、意思決定の課題では損失が出やすく、創造の課題では利得が出やすかった(Vaccaroら, 2024)。課題の型によってAIの使い方を変えるべきだという本稿の前提を支える結果である。ただし、リーダーシップの類型別にAI活用を比べた研究は、まだない。
第2章 なぜ単一AIへの依存が問題になるのか
2.1 優秀なAIほど、人間が考えなくなる危険
AIは情報収集、文章作成、分析など多くの知的作業を支援できる。しかしAIへの信頼が高まりすぎると、人間が自分で検証しなくなる。Microsoft Researchとカーネギーメロン大学の2025年の研究では、知識労働者319人を調べたところ、生成AIへの信頼が高い人ほど批判的思考が少なく、自分の能力に自信がある人ほど批判的思考が多かった(Leeら, 2025)。ただし自己申告に基づく研究であり、因果関係を直接証明したものではない。自動化の研究では、機械の判断に引きずられる「自動化バイアス」が、素人にも専門家にも起き、訓練や指示だけでは防げないことが知られている(Parasuraman & Manzey, 2010)。1983年の古典「自動化の皮肉」は、自動化が簡単な仕事を奪い、難しい仕事だけを人間に残すと指摘した(Bainbridge, 1983)。さらに、同じAIに頭を借りると、人間の判断が互いに似てくる。AIの助言を受けた人は個人としては正答率が上がる一方、人間固有の知識を失い、判断が均質化した(Fügenerら, 2021)。生成AIで短編小説を書くと、作品の評価は上がるが、作品同士が似通うという結果もある(Doshi & Hauser, 2024)。組織の全員が同じAIに相談すれば、組織から「異論」が消える。
2.2 AIへの依存とリーダーシップの喪失
ここで区別すべきなのは、AIへの依存とリーダーシップの喪失である。AIに多くの仕事を任せても、人間が目標を設定し、成果を評価し、必要に応じて修正できるなら、リーダーシップは維持され得る。問題は、AIに仕事を任せることではない。AIの成果を評価せず、そのまま採用するようになることである。その代償は、すでに現実になっている。2025年1月、米国ミネソタ州の連邦裁判所は、生成AIが作った存在しない論文の引用を含む専門家の意見書を、証拠から排除した(Kohls v. Ellison)。同年10月には、Deloitteオーストラリアが政府向け報告書の誤引用を理由に、代金の一部を返金している(AP配信)。どちらも、AIを使ったことではなく、人間が確かめなかったことが問われた。技術見解書を書く立場として、他人事とは思えない。
図1 単一AIへの過度な依存が生む悪循環
- AIが優秀な成果を出す
- 人間の信頼が高まる
- 人間による検証が減る
- 自分で判断する機会が減り、AIの誤りに気づきにくくなる
- AIへの依存がさらに強まる(→1へ)
この悪循環は筆者の仮説的なモデルであり、すべての利用者に起きるわけではない。上に挙げた研究も「AIへの依存」の研究であり、AIが「一つ」であることが原因だと示したものではない。それでも、リーダーシップを考えるうえで重要な問題提起になる。
第3章 複数AIはなぜ有効なのか
複数AIの活用には、三つの異なる目的がある。能力の補完、意見の比較、そしてAI同士による批判的検証である。
3.1 能力の補完
AIによって得意分野や使える機能は異なる。例えば一方に文献調査を任せ、もう一方に論点整理や報告書の構成を担当させる。これにより、単一のAIでは処理しにくい複雑な仕事を分担できる。
3.2 異なる意見の比較
同じ問題を複数のAIに独立して検討させる。一致する点と異なる点を比べれば、見落としや前提の違いを発見できる可能性がある。ただし、複数のAIが同じ誤答を出すことは珍しくない。350以上のAIを調べた研究では、二つのAIがどちらも間違えたとき、60%の確率で同じ誤答を選んでいた。高性能なAIほど、開発元が違っても間違い方が似ていた(Kimら, 2025)。AIの多数決は、真実を保証しない。
3.3 AI同士による批判的検証
ここが今回、特に強調したい点である。あるAIが作った成果物を、別のAIに批判的に評価させる。例えばAI-Aが技術報告書を作成したとする。その報告書をAI-Bに渡し、次のように依頼する。
この報告書の論理的な弱点、根拠の不足、事実誤認、反証可能性を批判的に検討してください。指摘には根拠となる資料を示し、重要度の高い順に並べてください。
AI-Bは、AI-Aの結論を無条件に受け入れず、問題点を指摘する。人間はその指摘を評価し、採用したものだけをAI-Aに戻して修正させる。最後に人間が、修正の根拠を確認して承認する。作成と批判を分け、採否と承認は人間が決める人間とAIが必要に応じて再レビューする。
① 人間が課題と評価基準を設定する。
② AI-Aが成果物を作成する。
③ AI-B(別の開発元)が弱点と誤りを根拠付きで指摘する。
④ 人間が指摘を照合し、採否を決める。
⑤ AI-Aが採用した指摘を反映させる。
⑥ 最後に人間が根拠を確認し、最終承認する。
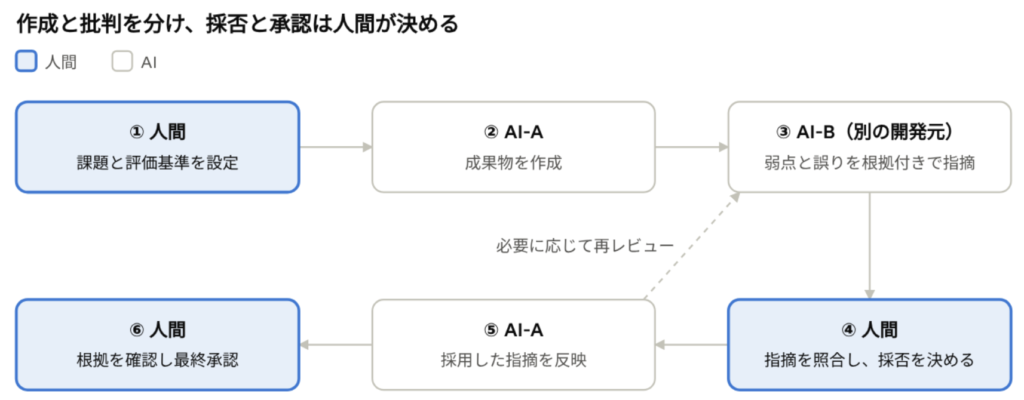
③の批判役には、作成役とは別の開発元のAIを使う方がよい。AIには自分が書いた文章を高く評価する癖があり(Panicksseryら, 2024)、同じAIに外部の情報なしで自分の推論を見直させても、改善しないどころか悪化することがあるからだ(Huangら, 2024)。企業の製品でも同じ発想が採り入れられている。
Microsoft 365 Copilotは2026年3月、GPTが下書きしClaudeが正確さや引用をレビューする「Critique」を発表した(報道)。
この方式には二つの期待効果がある。第一に、成果物の品質向上である。作成者とは異なる視点から批判を受ければ、見落としや論理の弱点を発見できる可能性がある。第二に、人間の判断支援である。人間は完成した報告書だけでなく、批判点、修正案、修正理由を比べられる。AIが一つの答えを示すだけの場合より、判断の根拠を検討しやすくなる。
ただし、批判AIの指摘が正しいとは限らない。誤った批判によって、成果物がかえって悪くなることもある。だから④では、人間が指摘を一次資料と照合し、一つずつ採否を決める。ここをAI同士のやり取りに任せると、人間は再び、最後に印を押すだけの役に戻ってしまう。
第4章 複数AIを組織する三つの方式
複数AIの基本的な組織方式を、直列型、並列型、ハイブリッド型に整理する。この分類は筆者の独創ではない。AI開発の現場で使われる「プロンプト連鎖」「並列化」「オーケストレーター・ワーカー」という設計パターンに、それぞれ対応する(Anthropic, 2024)。
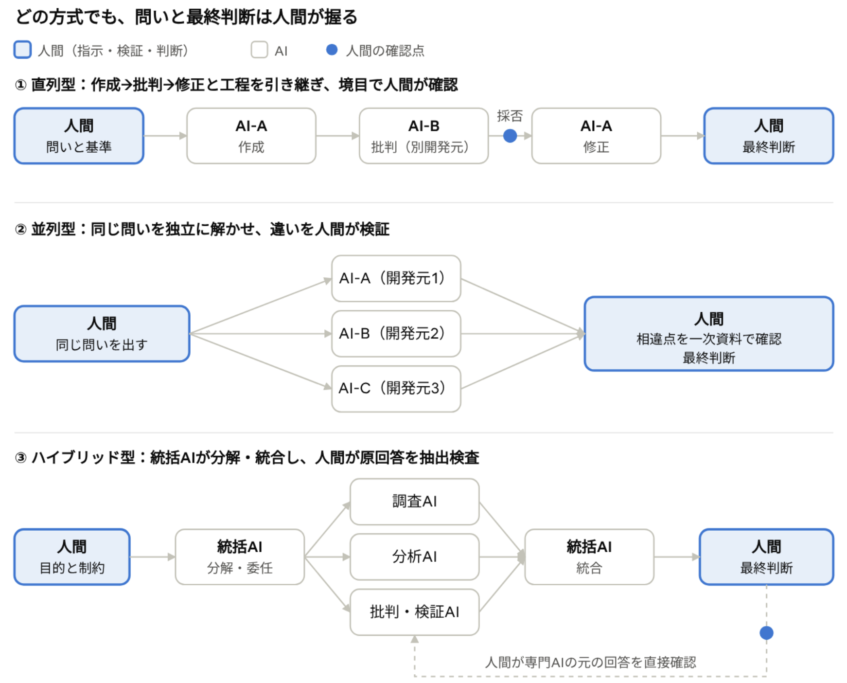
色付きの箱が人間である。どの方式でも、最初の「問い」と最後の「判断」は人間が担う。
4.1 直列型――工程分業と批判的検証
直列型では、工程ごとに異なるAIが役割を担う。技術調査、分析、報告書作成、レビューなどに向いている。特に作成と批判を分けることで、成果物の問題点を見つける機会を設けられる。ただし、上流の誤りが後工程へ伝わる危険がある。AIによる批判が必ず正しいわけでもない。
4.2 並列型――独立した意見の比較
人間が同じ課題を複数のAIに与え、それぞれの回答を比べて判断する。技術的な原因分析や将来予測のように、複数の見解が成り立ち得る課題に向く。AI同士に相互批判させることもできるが、その前に独立した初期回答を保存しておく。他のAIの回答を最初から見せると、判断が似通うからだ。AIの数は多ければよいわけではない。東京大学の実験(CHI 2026採択)では、1体・3体・5体のAIから助言を受けた人の正答率を比べた。3体は1体より正答率を高めたが、5体に増やしても上乗せはなかった。AIが全員一致だと人は過信し、意見が大きく割れると混乱した(Tsuchiya & Baba, 2026)。ただしこの実験のAIは大規模言語モデルではなく、課題も短い二択問題である。筆者は「2〜3体」を、人間が自分で検証し切れる数の目安として提案するにとどめる。
4.3 ハイブリッド型――統括AIと専門AI
ハイブリッド型では、秘書・参謀役の統括AIが仕事を分解し、調査・分析・批判などの専門AIに配り、結果をまとめる。複数分野にまたがる技術調査や経営戦略の検討に向く。Anthropicの調査機能はこの方式で、社内評価では単一AIより90.2%高い成績だった一方、計算量は通常のチャットの約15倍だった(Anthropic, 2025)。ただし、統括AIが批判的な意見を省いたり、誤って解釈したりする可能性がある。統括AIのまとめだけを読んでいると、単一AIへの依存と同じ状態に戻る。人間が専門AIの元の回答を直接確認できる経路を設けるべきである。
表2 三方式の比較
| 項目 | 直列型 | 並列型 | ハイブリッド型 |
|---|---|---|---|
| 主な目的 | 工程分業・改善 | 比較・相互検証 | 統合管理 |
| 批判の方法 | 次工程でレビュー | 相互批判 | 専門AIがレビュー |
| 長所 | 改善の過程が明確 | 異論を見つけやすい | 複雑な仕事に対応 |
| 主なリスク | 誤りの連鎖 | 同調・共通誤答 | 統括AIへの依存、費用増 |
| 対策 | 批判役は別の開発元のAI | 2〜3体。一致したときこそ一次資料で確認 | 専門AIの原回答を抽出検査 |
| 人間の役割 | 工程管理・承認 | 比較・評価 | 指揮・監督 |
第5章 実務型リーダーシップの三つのAI活用戦略
正解を事実と照合できる課題では、AIの役割は「疑わしい箇所を絞り込むこと」、人間の役割は「一次資料で確かめ、責任を持って判断すること」である。
5.1 直列型――作成・批判・修正
技術報告書を例に考える。AI-Aが文献を調査し、報告書の草案を作る。AI-Bがその草案を批判的にレビューする。AI-Aが、人間が採用した指摘を反映する。人間の専門家は、修正前後の内容と批判の妥当性を比べて、最終的な判断を下す。品質の向上と、判断の過程の透明化を同時に目指す方式である。
5.2 並列型――複数の技術的見解を比較する
例えば、電動自転車用バッテリーの発火原因を検討する場合を考える。一つのAIに設計・製造上の問題を分析させ、別のAIに外部要因を検討させる。さらに、両者の見解に対して反証を求める。ここで大事なのは、分析対象の事故について直接確認された事実と、一般的な発火要因とを区別することだ。答えが割れた箇所は、専門家が時間をかけて調べるべき箇所である。逆に、答えが一致したときに安心してはいけない。AI同士は同じ間違いをするからだ。人間の専門家は、各AIの結論を比べ、証拠によって支持される範囲を判断する。
5.3 ハイブリッド型――統括AIによる技術調査
論点の多い大型の調査では、統括AIが調査項目を分解し、専門AIに役割を割り当てる。結果を統合し、必要に応じて別のAIに批判的なレビューを依頼する。人間は、統括AIの報告だけでなく、重要な原資料や専門AIの成果を自分で確かめる。
5.4 私自身のAI活用例
現在、私はChatGPTとClaudeを組み合わせて技術見解書の作成を進めている。ChatGPTと論点を整理し、Claudeに詳細調査を依頼する。Claudeの報告書をChatGPTに批判的に検討させ、指摘された問題を再検討する。この過程で、報告書の構成、根拠の強さ、表現の適切さを見直している。実は本稿も、同じ手順で仕上げている。
手順を書き出すと、次のようになる。
- AIに聞く前に、自分の初期仮説を書き留める
- AI-Aに文献調査と分析をさせる
- 開発元の異なるAI-Bに、反証と引用の誤りだけを探させる
- 指摘ごとに採否を決め、引用は全件、一次資料で確認する
- 各主張を「確認済みの事実」「AIによる推論」「専門家としての判断」に分けて書く
- AIの利用範囲を文書に明記する
重要なのは、AIが出した結論をそのまま採用するのではなく、異なるAIの意見を比べることで、自分自身の判断を深めることである。ただし、これは私自身の実務経験に基づく観察であり、品質改善の効果を定量的に実証したものではない。
第6章 ビジョン型リーダーシップの三つのAI活用戦略
実務型では、与えられたミッションの達成が目的になる。一方、ビジョン型では、将来のあるべき姿を描き、その実現に向けて組織を変えることが目的となる。正解のない課題では、AIの役割は「複数の未来を示すこと」、人間の役割は「どの未来を目指し、何に備えるかを決めること」である。
6.1 直列型――未来予測から戦略立案へ
AI-Aが市場や技術の将来を予測する。AI-Bが、その予測を前提に戦略案を作る。AI-Cが、戦略案の弱点やリスクを批判的に検討する。人間は、予測の前提と戦略の妥当性を評価する。論理の一貫性は保てるが、最初の予測の偏りが最後まで残る。各段階で「この前提が間違っていたらどうなるか」を問い直す必要がある。この方式については、直接の実証研究は見つからなかった。
6.2 並列型――異なる未来を比較する
複数のAIに独立した未来予測を依頼する。例えば、ある技術市場について、成長・停滞・縮小などのシナリオを検討させる。人間は、それぞれの予測の前提、確率、影響を比べる。六つの戦略のうち、最も裏付けがあるのがこの方式である。12のAIの予測を集約すると、925人の人間の集約予測と同等の精度になった(Schoeneggerら, 2024)。ただし、これは数か月先の「起きるか起きないか」の予測である。数年先の構造変化を扱う経営ビジョンに、そのまま当てはまるとは限らない。ここで重要なのは、最も確率が高い未来だけを選ぶことではない。複数の未来に対して、どのような戦略を取るべきかを考えることである。
6.3 ハイブリッド型――経営者の参謀AI
経営者は、常に相談できる秘書・参謀AIを持つ。参謀AIは、必要に応じて市場、技術、財務、法務などの専門AIに調査を依頼する。さらに、反対役のAIに戦略の弱点を指摘させる。経営者は、統合された報告と批判的な意見を比べ、最終的な方向性を決める。オーストラリアの州政府では、生成AIを使った戦略的フォーサイトの実証が行われた。シナリオ作りは効率化されたが、人間による検証と監督は欠かせないと結論されている(Picavetら, 2025)。筆者が懸念するのは、競合他社が同じAIでシナリオを作れば、戦略が似通ってしまうことである。反対役のAIに加えて、人間の助言者も手放さない方がよい。AIは未来を予測する。しかし人間は、実現したい未来を選び、その未来に向けて行動する。ここに、ビジョン型リーダーシップの本質があると考える。
第7章 6つのAI活用戦略を比較する
二つのリーダーシップと三つのAI組織方式を組み合わせると、六つの活用戦略が得られる。「根拠の強さ」は、研究や事例でどこまで裏付けられているかを示す。
表3 実務型・ビジョン型×三方式の6つの戦略
| 戦略 | 主な活用方法 | 人間の役割 | 根拠の強さ |
|---|---|---|---|
| ① 実務型×直列 | 作成・批判・修正 | 批判の採否、品質評価、承認 | 中(企業の実装あり) |
| ② 実務型×並列 | 独立した技術分析 | 相違点の比較・検証 | 中(実験研究あり) |
| ③ 実務型×ハイブリッド | 統括AIによる業務管理 | 指揮・監督、原回答の抽出検査 | 中(企業の自社評価) |
| ④ ビジョン型×直列 | 予測・戦略・批判 | 前提の確認、戦略判断 | 弱(類推) |
| ⑤ ビジョン型×並列 | 複数の未来シナリオ | 未来の選択 | 中〜強(短期予測の精度) |
| ⑥ ビジョン型×ハイブリッド | 参謀AIによる戦略支援 | ビジョン形成・意思決定 | 弱〜中(行政での実証) |
この六分類は筆者が提案する概念モデルであり、分類そのものの有効性を直接検証した研究はまだない。それでも、AIを使う目的と、人間が担うべき役割を整理する枠組みとしては役に立つと考える。
第8章 AIによる批判的レビューの効果と限界
8.1 批判的レビューは品質向上につながるか
AI同士に批判的なレビューをさせることには、一定の可能性がある。一方のAIが見落とした論点を、別のAIが指摘できる場合があるからだ。ただし、研究は楽観を許さない。AI同士に討論させる方法は、同じAIに何度か答えさせて多数決を取る単純な方法を、安定して上回るわけではなかった(Smitら, 2024)。AIが外部の情報を使わずに自分の推論を直そうとすると、改善しないか、かえって悪化することもある(Huangら, 2024)。複数AIの失敗を分析した研究は、14種類の失敗パターンを挙げている(Cemriら, 2025)。したがって、批判的レビューを導入するときは、次の五点が重要になる。
- 作成AIと批判AIの役割を明確に分ける(できれば開発元も分ける)
- 批判AIには、賛同ではなく問題点の発見を求める
- 批判には、根拠や一次資料を示させる
- 批判の採否は人間が決める
- 修正後の成果物が本当に良くなったかを確かめる
8.2 人間の判断力をどう高めるか
批判的レビューのもう一つの意義は、人間の判断支援にある。完成した報告書だけを読むと、人間はAIの結論を受け入れやすくなる。別のAIがその弱点を指摘していれば、人間は何を確かめればよいかをつかみやすい。つまり批判AIは単なる校正者ではなく、人間が主体的に判断するための論点を示す役割を担う。この考え方は制度にも現れている。EU AI法第14条は、高リスクAIを監督する人が自動化バイアスを自覚し、出力を覆し、停止できることを求めている(欧州委員会)。第1章の「評価と選択」「修正と停止」は、まさにこの権限に当たる。ただし、批判AIの指摘が多すぎると、人間の負担が増え、かえって判断が難しくなる。先の東京大学の実験でも、意見が大きく割れると人は混乱した。重要度の高い問題から順位を付けさせ、必要な部分だけを人間が詳しく検討できる仕組みが望ましい。
第9章 未来予測は外れてもよい――重要なのは学習すること
ビジョン型リーダーシップで本当に大事なのは、予測が当たることより、外れたときに素早くビジョンを直せることである。未来は不確実だという前提で、複数のシナリオを用意しておく。そして予測が外れたら、まず「予測そのものの問題」と「戦略実行上の問題」を区別する。
表4 外れ方の分類と直すべきもの
| 区分 | 外れ方 | 例 | 直すべきもの |
|---|---|---|---|
| 予測の問題 | 情報の不足 | 知り得た情報を集めていなかった | 情報源、調査の範囲 |
| 予測の問題 | 前提の誤り | 複数のAIがそろって同じ方向に外した | AIの組合せ、人間の予測の比重 |
| 予測の問題 | 想定外の事象 | どのシナリオにも入っていなかった | シナリオの幅、備えの余力 |
| 実行の問題 | 目標設定の誤り | 目指すべき未来の選び方が適切でなかった | ビジョン、評価基準 |
| 実行の問題 | 資源配分の不足 | 予測は当たったが投資が足りなかった | 予算、人員の配分 |
| 実行の問題 | 実行の失敗 | 計画は正しかったが組織が動けなかった | 組織、意思決定の速さ |
これを区別して原因を分析し、次の予測と戦略に反映する。そのための循環を次に示す。
図4 予測・実行・検証・修正の循環
- 現状分析:人間が問いと前提を整理する
- 予測:複数のAIと人間がそれぞれ独立に、確率で予測する。「いつまでに」「なぜ」「誰の予測か」を記録する
- ビジョン形成:人間が、どの未来を目指し何に備えるかを決める
- 実行:戦略を実行する
- 検証:結果が出たら、予測と実績を比べて採点する
- 修正:表4で外れ方を分類し、ビジョンとAIの組合せを見直して、2に戻る
採点には、予測研究で標準的な「ブライアスコア」が使える。確率と実際の結果の差の二乗平均で、小さいほど良い(Halawiら, 2024)。要は、予測をしたその時点で記録しておくことだ。記録がなければ、後知恵で「実は分かっていた」と思い込んでしまう。なお、この循環は筆者の提案であり、複数AIと組み合わせた効果を示した研究はまだ見当たらない。重要なのは、予測が外れたことではない。なぜ外れたのかを明らかにし、次の判断に生かすことである。
第10章 結論――AI時代のリーダーは何をすべきか
AIが優秀になるほど、人間の仕事は変わる。情報収集、分析、資料作成は、AIに支えられるようになる。しかし、それは人間のリーダーシップが不要になるという意味ではない。むしろ、人間には次の五つの能力が求められる。
- 何を実現したいのかという目的を明確にする能力
- 複数AIの専門能力を組織する能力
- AI同士の異なる意見や批判を評価する能力
- 成果物を一次資料で検証し、必要に応じて修正する能力
- 最終的な判断と責任を引き受ける能力
私は、複数AIを活用することで、人間がより主体的に判断できる組織構造を設計できると考えている。ただし、複数AIを使えば必ずリーダーシップが維持されるわけではない。AI同士は同じ間違いをし、全員一致は人を過信させ、統括AIのまとめは単一AIへの依存と同じ状態を生む。大切なのは、AIを何体使うかではなく、人間が何を判断し、どこで指揮権を行使するかである。AI同士の批判的な検証は、その判断を支える有力な方法の一つになり得る。自動化されたシステムの事故では、実際の権限が小さい現場の人間に責任が集中しやすいという指摘もある(Elish, 2019)。AIを何体使おうと、署名するのは人間である。だからこそ、署名に見合う判断の権限を、自分の手元に残しておかなければならない。AI時代のリーダーシップとは、AIに勝つことでも、AIにすべてを任せることでもない。AIの能力を組織し、異なる意見を評価し、自ら未来を選択することである。
参考文献
リーダーシップと自動化
- Bainbridge, L. (1983). Ironies of automation. Automatica, 19(6), 775–779. doi:10.1016/0005-1098(83)90046-8
- Parasuraman, R., & Manzey, D. H. (2010). Complacency and bias in human use of automation: An attentional integration. Human Factors, 52(3), 381–410. doi:10.1177/0018720810376055
- Judge, T. A., & Piccolo, R. F. (2004). Transformational and transactional leadership: A meta-analytic test of their relative validity. Journal of Applied Psychology, 89(5), 755–768. doi:10.1037/0021-9010.89.5.755
- Elish, M. C. (2019). Moral crumple zones: Cautionary tales in human-robot interaction. Engaging Science, Technology, and Society, 5, 40–60. doi:10.17351/ests2019.260
人間とAIの協働・依存
- Lee, H.-P., et al. (2025). The impact of generative AI on critical thinking. CHI ’25. doi:10.1145/3706598.3713778
- Vaccaro, M., Almaatouq, A., & Malone, T. (2024). When combinations of humans and AI are useful: A systematic review and meta-analysis. Nature Human Behaviour, 8, 2293–2303. doi:10.1038/s41562-024-02024-1
- Fügener, A., et al. (2021). Will humans-in-the-loop become Borgs? Merits and pitfalls of working with AI. MIS Quarterly, 45(3). doi:10.25300/MISQ/2021/16553
- Doshi, A. R., & Hauser, O. P. (2024). Generative AI enhances individual creativity but reduces the collective diversity of novel content. Science Advances, 10(28). doi:10.1126/sciadv.adn5290
- Tsuchiya, Y., & Baba, Y. (2026). More isn’t always better. CHI 2026. arXiv:2603.22152
複数AI・自己修正・批判
- Huang, J., et al. (2024). Large language models cannot self-correct reasoning yet. ICLR 2024. arXiv:2310.01798
- Smit, A., et al. (2024). Should we be going MAD? A look at multi-agent debate strategies for LLMs. ICML 2024. PMLR
- Kim, E. M., et al. (2025). Correlated errors in large language models. ICML 2025. PMLR
- Panickssery, A., et al. (2024). LLM evaluators recognize and favor their own generations. NeurIPS 2024. doi:10.52202/079017-2197
- Cemri, M., et al. (2025). Why do multi-agent LLM systems fail? NeurIPS 2025. arXiv:2503.13657
- Anthropic (2024). Building effective agents
- Anthropic (2025). How we built our multi-agent research system
予測とフォーサイト
- Schoenegger, P., et al. (2024). Wisdom of the silicon crowd. Science Advances, 10(45). doi:10.1126/sciadv.adp1528
- Halawi, D., et al. (2024). Approaching human-level forecasting with language models. NeurIPS 2024. doi:10.52202/079017-1598
- Picavet, M., et al. (2025). Human-machine collaboration for strategy foresight. Public Administration Review. doi:10.1111/puar.70048
制度・事例
- European Union. AI Act, Article 14: Human oversight
- Kohls v. Ellison(米国ミネソタ州連邦地裁、2025年1月)の報道
- Deloitteオーストラリアの返金(2025年10月)のAP配信
- Microsoft 365 Copilot「Critique」(2026年3月)の報道